AI & computing › AI-gestuurde wetenschappelijke ontdekkingen
Wetenschappers muteren elke DNA-letter van een virus – AI kan het amper volgen
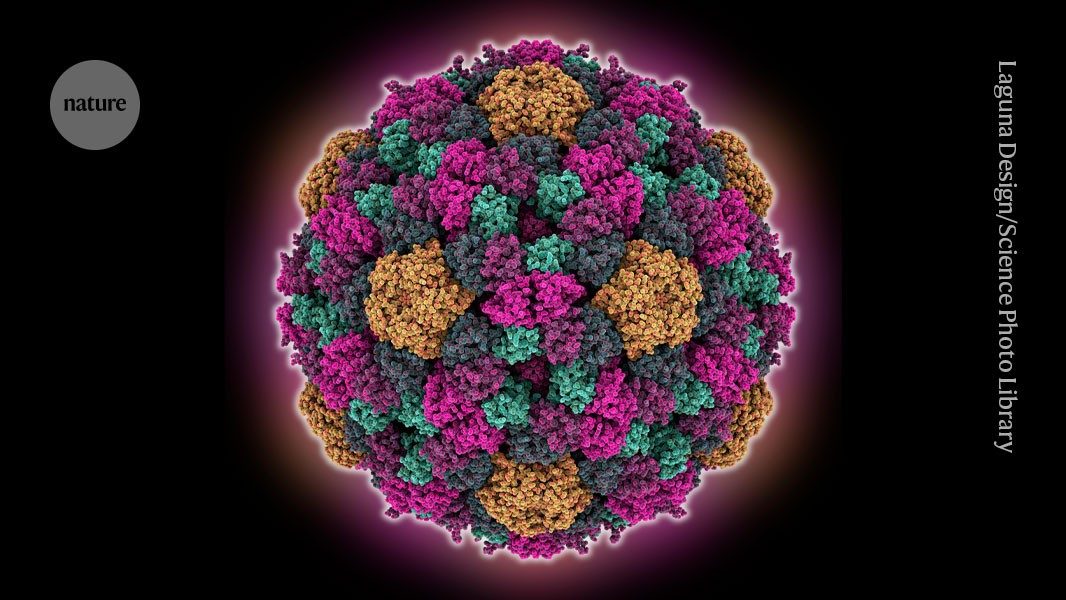
Onderzoekers hebben voor het eerst het complete genoom van een virus letter voor letter gemuteerd en onderzocht wat elke verandering doet. Het gaat om de bacteriofaag phi X174, al decennia een modelorganisme in de moleculaire biologie. Opvallend genoeg kunnen zelfs geavanceerde AI-modellen niet goed voorspellen welke mutaties dodelijk zijn voor het virus.
Onderzoekers hebben voor het eerst het complete genoom van een virus letter voor letter gemuteerd en onderzocht wat elke verandering doet. Het gaat om de bacteriofaag phi X174, een simpel virus dat al decennia geldt als modelorganisme in de moleculaire biologie. De resultaten laten zien dat zelfs na vijftig jaar onderzoek een kwart van de schadelijke mutaties nog altijd een raadsel is – en dat AI-modellen die schade proberen te voorspellen, het effect vaak niet goed inschatten.
Bijna 44.000 varianten getest
Het genoom van phi X174 bestaat uit 5.386 DNA-letters (nucleotiden) en codeert voor elf eiwitten. Het was in de jaren zeventig het eerste virus waarvan het complete genoom werd afgelezen, en in de jaren 2000 het eerste dat volledig kunstmatig werd nagemaakt met DNA-synthese. Een team onder leiding van moleculair bioloog Ben Lehner van het Wellcome Sanger Institute in Groot-Brittannië maakte nu ruim 44.000 varianten van het virus, door op elke positie in het genoom alle mogelijke aanpassingen aan te brengen. Dat gebeurde zowel op het niveau van losse DNA-letters als op het niveau van de aminozuren waaruit de virale eiwitten zijn opgebouwd – een methode die bekendstaat als saturatiemutagenese.
Om te meten welke varianten levensvatbaar bleven, lieten de onderzoekers duizenden gemuteerde virussen tachtig minuten lang concurreren in een kweek met de bacterie Escherichia coli, de gastheer die phi X174 normaal infecteert. Varianten die zich succesvol vermenigvuldigden, overleefden het experiment; virussen met een schadelijke mutatie stierven uit. Uit DNA-sequencing bleek dat de helft van alle losse letterveranderingen schadelijk was, en zelfs 60 procent van de aminozuurveranderingen. Dat is een veel hoger percentage dan de onderzoekers hadden verwacht van een virus dat al tientallen jaren in het laboratorium wordt gebruikt en optimaal aan die omstandigheden lijkt te zijn aangepast. Een handvol mutaties maakte het virus zelfs nog iets fitter.
AI-modellen missen de fijne details
Van de schadelijke mutaties kon het team voor ongeveer de helft een verklaring vinden: ze verstoorden bijvoorbeeld de interactie tussen virale eiwitten onderling, of met eiwitten van de gastheerbacterie. Een kwart trof aminozuren diep in de kern van een eiwit, wat waarschijnlijk de structuur van dat eiwit ondermijnt. Voor de rest – honderden mutaties – hebben de onderzoekers geen idee wat er precies misgaat. Ook geavanceerde AI-systemen die zijn ontwikkeld om schadelijke mutaties te herkennen, bijvoorbeeld via technieken voor eiwitstructuurvoorspelling, bleken grote moeite te hebben om de effecten van de veranderingen in phi X174 goed te voorspellen.
Dat is opvallend, omdat phi X174 tot de best bestudeerde biologische systemen ter wereld behoort. Volgens Lehner onderstreept dit vooral dat AI-modellen voor biologie nog altijd afhankelijk zijn van grote hoeveelheden experimentele data om betrouwbaar te worden. De bacteriofaag geldt niet voor niets als icoon in de geschiedenis van de genetica: het was niet alleen het eerste gesequencede en het eerste synthetisch nagemaakte genoom, maar diende recent ook als basis voor de allereerste door AI ontworpen virusgenomen. Juist daarom is de nieuwe studie een test voor hoever kunstmatige intelligentie werkelijk is doorgedrongen in het doorgronden van leven op moleculair niveau.
Achtergrond & begrippen
Wat betekent dit voor de toekomst? Deze studie laat zien dat zelfs het best bestudeerde virus ter wereld nog vol verrassingen zit, en dat AI-modellen voor biologie nog lang niet zo slim zijn als vaak wordt aangenomen. Voor de ontwikkeling van veilige, door AI ontworpen genomen en medicijnen betekent dit dat onderzoekers eerst nog veel meer experimentele data moeten verzamelen voordat ze algoritmes blindelings kunnen vertrouwen.
- Bacteriofaag
- Een virus dat specifiek bacteriën infecteert; phi X174 is zo'n virus en geldt als modelorganisme in de genetica.
- Nucleotide
- Een van de chemische bouwstenen (de 'letters') waaruit een DNA-streng is opgebouwd.
- Aminozuur
- De bouwsteen van eiwitten; de volgorde van aminozuren bepaalt de vorm en functie van een eiwit.
- Saturatiemutagenese
- Een techniek waarbij onderzoekers stelselmatig alle mogelijke mutaties op elke positie in een gen of genoom aanbrengen om hun effect te meten.
- DNA-synthese
- Het chemisch namaken van een DNA-streng vanaf nul, zonder gebruik te maken van een bestaand organisme.
- Eiwitstructuurvoorspelling
- Het gebruik van computermodellen, vaak op basis van AI, om te voorspellen welke driedimensionale vorm een eiwit aanneemt en hoe mutaties die vorm beïnvloeden.
- Modelorganisme
- Een relatief eenvoudig organisme dat wetenschappers gebruiken om algemene biologische principes te bestuderen, omdat het goed te kweken en te onderzoeken is.
- Genoom
- De volledige verzameling erfelijk materiaal van een organisme of virus.
Bronnen
Dit artikel is met behulp van AI geschreven op basis van bovenstaande bronnen en is geen letterlijke vertaling. Zo werkt onze redactie.