AI & computing › AI-gestuurde wetenschappelijke ontdekkingen
AI-platform AdaptiveFlow screent 69 miljard moleculen voor nieuwe medicijnen
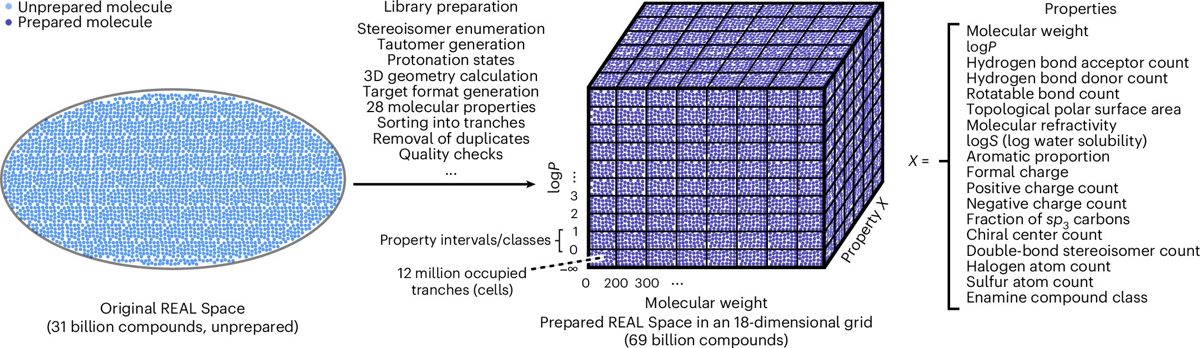
Amerikaanse en Italiaanse onderzoekers presenteren AdaptiveFlow, een open-source AI-platform dat miljarden potentiële medicijnmoleculen kan doorzoeken tegen duizend keer lagere rekenkosten dan bestaande methoden. Het systeem doorzocht als test al 69 miljard moleculen en vond veelbelovende kandidaten tegen twee kankereiwitten.
Onderzoekers van het Amerikaanse St. Jude Children's Research Hospital, Dana-Farber Cancer Institute en Harvard Medical School hebben samen met de Italiaanse Universiteit van Pavia een nieuw AI-platform ontwikkeld dat de zoektocht naar nieuwe medicijnen drastisch goedkoper maakt. Het systeem, AdaptiveFlow genaamd, kan miljarden kandidaat-moleculen tegen een ziekte-eiwit testen tegen een fractie van de rekenkosten die daar tot nu toe voor nodig waren. De resultaten zijn gepubliceerd in het wetenschappelijke tijdschrift Nature Biotechnology.
Duizend keer goedkoper rekenen
Het testen van moleculen tegen een ziekmakend eiwit gebeurt steeds vaker virtueel, in de computer in plaats van in het laboratorium. Dat heet hoogdoorvoerscreening: software voorspelt welke van duizenden of miljoenen stoffen mogelijk goed aan een doeleiwit binden, zodat onderzoekers alleen de veelbelovendste kandidaten nog echt hoeven te testen in het lab. Het probleem is dat de allergrootste chemische bibliotheken, met tientallen miljarden moleculen, tot nu toe onbetaalbaar waren om volledig te doorzoeken. AdaptiveFlow doorbreekt die grens: het platform schaalt vrijwel foutloos op tot 5,6 miljoen processorkernen tegelijk, een nieuw record voor dit soort cloudberekeningen. Daardoor kon het team 69 miljard moleculen doorzoeken uit de Enamine REAL Space, naar eigen zeggen de grootste kant-en-klare moleculenbibliotheek ter wereld.
Slim zoeken in achttien dimensies
De efficiëntie zit vooral in de manier waarop AdaptiveFlow selecteert wélke moleculen de moeite waard zijn om diepgaand te onderzoeken. Het platform rangschikt elke stof in een rooster met achttien dimensies, waarbij elke dimensie een eigenschap van het molecuul weergeeft, zoals het moleculaire gewicht. Op basis van een eerste steekproef binnen dat rooster traint het systeem een classificatiemodel dat voorspelt welke moleculen kansrijk zijn. Alleen die subgroep gaat vervolgens door moleculaire docking: een berekening die inschat hoe goed een molecuul fysiek past op het doeleiwit, met meer dan 1.500 ondersteunde dockingmethoden. De stoffen worden daarna gerangschikt op hun voorspelde bindingsaffiniteit, oftewel hoe sterk ze naar verwachting aan het doeleiwit hechten. Volgens hoofdonderzoeker Christoph Gorgulla van St. Jude leveren deze eerste treffers vaak al een hogere kwaliteit op dan bij traditionele methoden, wat later in het onderzoeksproces tijd en geld bespaart.
Test op twee kankereiwitten
Om te bewijzen dat het systeem werkt, zette het team AdaptiveFlow in tegen twee eiwitten die een rol spelen bij kanker. Het eerste is PARP1, een bekend doelwit waarvoor al goedgekeurde medicijnen bestaan en dat daarom als ijkpunt diende. Het tweede is FSP1, een eiwit dat celdood tegengaat en de laatste jaren in verband is gebracht met het overleven van kankercellen. FSP1 geldt als lastiger doelwit omdat de bindingsplek een extra hulpstof bevat die het proces compliceert. In beide gevallen vond AdaptiveFlow kandidaat-remmers met een bindingssterkte die vergelijkbaar is met bestaande, klinisch relevante medicijnen. Dat sterkt de onderzoekers in de overtuiging dat het platform ook bruikbaar is voor moeilijker bereikbare doelwitten waarvoor nog nauwelijks remmers bestaan.
AdaptiveFlow is volledig open source en gratis te downloaden, inclusief handleidingen, zodat ook onderzoeksgroepen met beperkte middelen toegang krijgen tot ultragrootschalige cloud-computing voor medicijnonderzoek. De hoop is dat dit leidt tot snellere ontdekking van nieuwe behandelingen, juist voor ziektes waarvoor nu nog weinig opties bestaan.
Achtergrond & begrippen
Wat betekent dit voor de toekomst? Als virtueel doorzoeken van miljarden moleculen honderden keren goedkoper wordt, kunnen ook kleinere onderzoeksgroepen en universiteiten meedoen aan grootschalig medicijnenonderzoek dat voorheen was voorbehouden aan grote farmaceutische bedrijven. Dat kan de ontwikkeling van behandelingen tegen moeilijk te behandelen ziektes, zoals bepaalde vormen van kanker, versnellen en toegankelijker maken.
- Hoogdoorvoerscreening
- Het razendsnel testen van duizenden tot miljarden moleculen in de computer om te zien welke mogelijk goed werken tegen een ziekte-eiwit.
- Moleculaire docking
- Een berekening die voorspelt hoe goed een molecuul fysiek past op de bindingsplek van een doeleiwit.
- Bindingsaffiniteit
- De maat voor hoe sterk een molecuul aan een eiwit hecht; hoe hoger de affiniteit, hoe krachtiger het effect meestal is.
- Classificatiemodel
- Een op machine learning gebaseerd model dat leert voorspellen in welke categorie iets valt, in dit geval welke moleculen kansrijk zijn.
- Cloud-computing
- Het gebruik van rekenkracht en opslag via internet, verspreid over datacenters, in plaats van op een eigen computer.
- Moleculebibliotheek
- Een verzameling van chemische stoffen die als kandidaat kan dienen voor nieuwe medicijnen.
- Eiwitremmer
- Een molecuul dat de werking van een specifiek eiwit blokkeert, vaak gebruikt als basis voor een medicijn.
- PARP1
- Een eiwit dat betrokken is bij DNA-reparatie in cellen en een bekend doelwit is voor bestaande kankermedicijnen.
- FSP1
- Een eiwit dat een vorm van celdood (ferroptose) onderdrukt en recent in verband is gebracht met het overleven van kankercellen.
Bronnen
Dit artikel is met behulp van AI geschreven op basis van bovenstaande bronnen en is geen letterlijke vertaling. Zo werkt onze redactie.