AI & computing › Agentic AI & autonome agents
Spotify-tool bespaart tot 90 procent aan AI-tokens bij programmeren
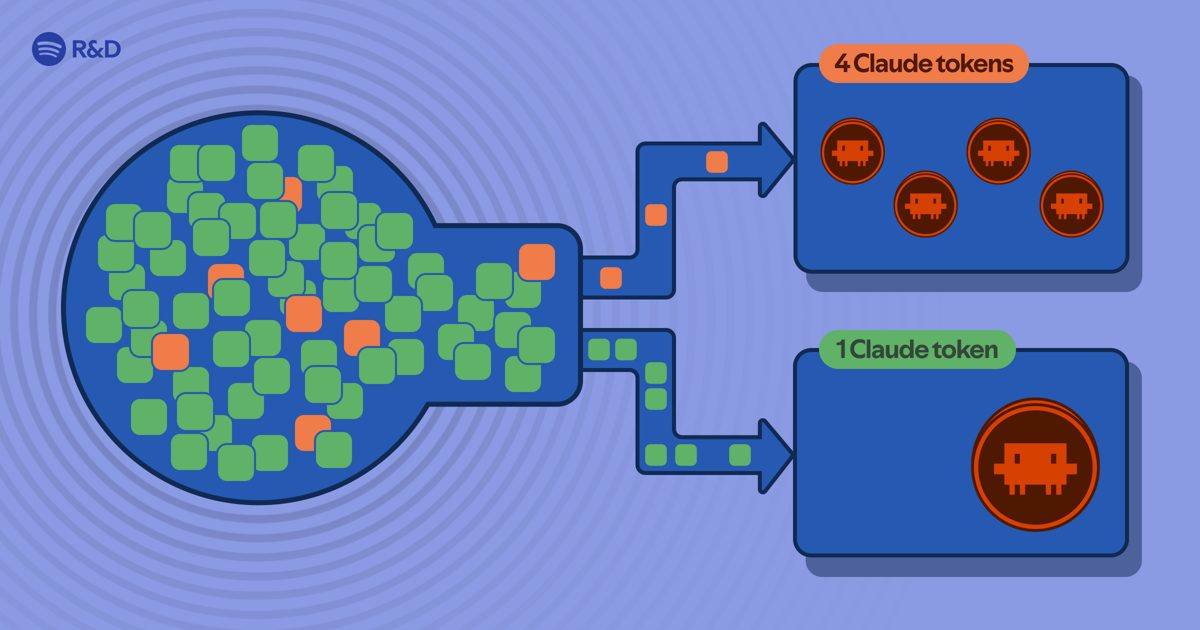
Een Spotify-engineer bespaarde tot 90 procent op zijn AI-tokenverbruik door simpel leeswerk en sjabloon-code niet meer naar een duur AI-model te sturen, maar naar een goedkoper model. De truc: twee kleine 'modes' in Spotify's interne tool Portal die grunt work overnemen van de dure programmeerassistent Claude Code.
Programmeren met AI-assistenten zoals Claude Code kost geld per woordje tekst dat het model verwerkt, ook wel tokens genoemd. Veel van dat verbruik gaat niet naar ingewikkeld denkwerk, maar naar simpel maar omvangrijk werk: vijf bestanden doorlezen om één vraag te beantwoorden, of een testbestand schrijven dat exact hetzelfde patroon volgt als twintig andere testbestanden. Dat is duur, omdat het altijd het meest geavanceerde en dus duurste model gebruikt, ook voor taken die geen zware redenering vereisen.
Dat probleem is groter dan één ontwikkelaar. Onderzoek waar het artikel naar verwijst, voorspelt dat de kosten van AI-programmeertools tegen 2028 hoger kunnen uitvallen dan het salaris van een gemiddelde ontwikkelaar. Een kwart van de IT-managers geeft nu al 200 tot 500 dollar per ontwikkelaar per maand uit aan AI-tokens, en sommige bedrijven zitten al boven de 2000 dollar.
Twee simpele taken, één goedkoper model
De oplossing kwam van Portal, een intern platform van Spotify voor het bouwen van AI-agents. Met zogeheten AiKA Modes kun je declaratief een agent definiëren: je kiest een taalmodel, stelt instructies op en Portal regelt de rest, zonder eigen server of API-sleutels. De Spotify-engineer maakte twee van zulke modes. De eerste, bulk-reader, leest grote hoeveelheden broncode en geeft alleen een kort, feitelijk antwoord terug. De tweede, code-writer, genereert sjabloon-code zoals tests of configuratiebestanden op basis van bestaande voorbeelden. Beide draaien op Gemini 2.5 Flash, een goedkoper model dan de dure taalmodellen die Claude Code normaal gebruikt.
Om dit automatisch te laten werken, bouwde de auteur een plugin genaamd shunt. Die grijpt in vlak voordat Claude Code een bestand wil lezen: is het bestand groter dan 350 regels, dan blokkeert de plugin die actie en stuurt de taak in plaats daarvan door naar de goedkopere bulk-reader. Twee losse bash-scripts regelen de communicatie met Portal, en losse instructiebestanden vertellen Claude Code wanneer en hoe het moet doorverwijzen naar het goedkopere model.
Waar de grens ligt
De aanpak werkt niet overal. Bewerkingen aan code kunnen niet worden gedelegeerd, omdat het goedkopere model geen betrouwbare regelnummers teruggeeft die Claude Code nodig heeft om iets aan te passen. Ook complex redeneerwerk, zoals het opsporen van een subtiele bug, blijft voorbehouden aan het dure model: in een test miste het goedkopere model een probleem met gelijktijdige processen dat het dure model direct doorhad. Daarnaast kost elke doorverwijzing tijd, meestal tien tot dertig seconden, omdat het verzoek eerst naar Portal en vervolgens naar het werkmodel moet reizen. Voor kleine taken weegt die vertraging niet op tegen de besparing, vandaar de grens van 350 regels.
Het idee achter deze AI-programmeertool is breder dan alleen Claude Code: dezelfde modes zijn te hergebruiken in elk project en met elk ander gereedschap dat Portal kan aanroepen. Spotify deelt de twee modes bovendien openbaar binnen het bedrijf, zodat andere teams ze meteen kunnen gebruiken zonder zelf iets te bouwen.
Achtergrond & begrippen
Wat betekent dit voor de toekomst? Naarmate AI-programmeerassistenten gangbaarder worden, groeit ook de rekening voor het gebruik ervan. Slim schakelen tussen dure en goedkope AI-modellen, per taak, kan bedrijven helpen de kosten van AI-programmeertools binnen de perken te houden zonder in te leveren op de kwaliteit van complex denkwerk. Dit soort kostenbewuste "model routering" zal de komende jaren waarschijnlijk een standaardonderdeel worden van elke AI-werkomgeving.
- AI-token
- De kleine tekstfragmenten waarin een taalmodel tekst opdeelt; het gebruik ervan bepaalt de rekenkosten van AI.
- Agent
- Een AI-systeem dat zelfstandig taken uitvoert, zoals code lezen of schrijven, op basis van vooraf gegeven instructies.
- Modelroutering
- De techniek waarbij een systeem automatisch bepaalt welk AI-model het beste (en goedkoopst) een specifieke taak kan uitvoeren.
- Serverloos rekenen
- Een manier van computergebruik waarbij code kortstondig draait op gedeelde infrastructuur, zonder dat de gebruiker zelf een server hoeft te beheren.
- Promptengineering
- Het zorgvuldig opstellen van instructies voor een AI-model, zodat het precies de gewenste output levert.
- Boilerplate-code
- Standaardcode die telkens hetzelfde patroon volgt, zoals testbestanden of configuratiebestanden, en daardoor makkelijk te automatiseren is.
- Hook
- Een stukje software dat automatisch wordt uitgevoerd vlak vóór of na een bepaalde actie, bijvoorbeeld om die actie te blokkeren of om te leiden.
Bronnen
Dit artikel is met behulp van AI geschreven op basis van bovenstaande bronnen en is geen letterlijke vertaling. Zo werkt onze redactie.