AI & computing › Generatieve AI & synthetische media
Robots leren voelen: tastdata verdubbelt succes bij fijn handwerk
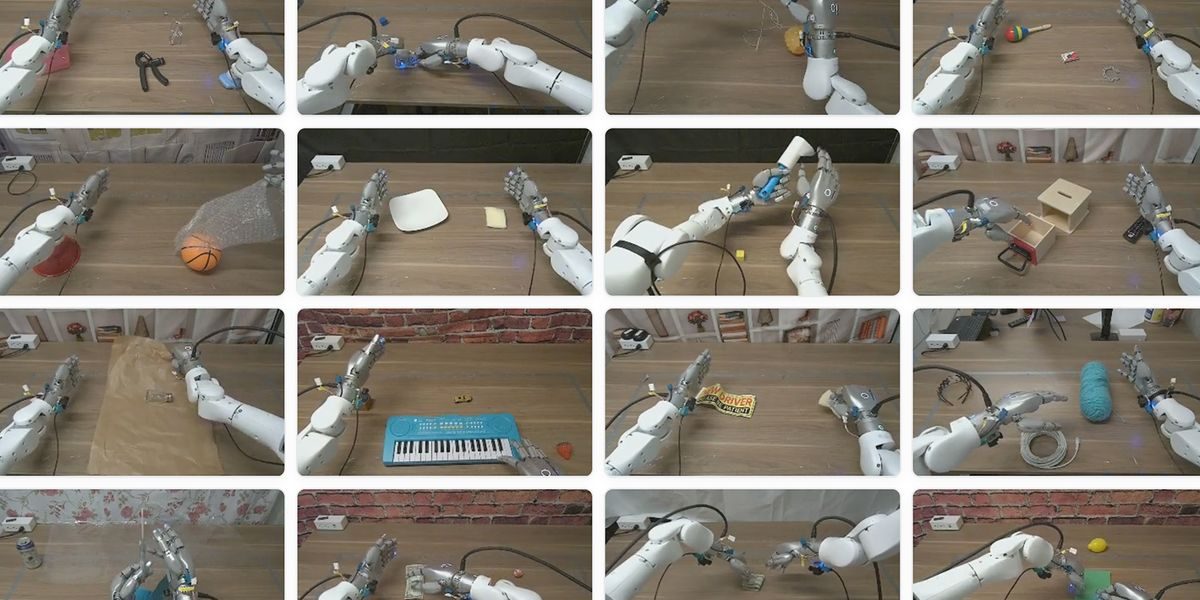
Robots kunnen steeds beter praten en kijken, maar struikelen vaak over fijn werk zoals een stekker insteken of een sleutel omdraaien. Nieuwe datasets met tastinformatie moeten daar verandering in brengen. Onderzoekers van onder meer UC Berkeley en Tsinghua University tonen aan dat robots met een 'gevoel' voor aanraking bijna dubbel zo vaak slagen in lastige taken.
Robots kunnen steeds beter huishoudelijke taken uitvoeren dankzij grote AI-modellen die zien, praten en handelen combineren. Maar zodra het om fijn werk gaat — een usb-stekker in het stopcontact duwen, een sleutel omdraaien, tandpasta op een borstel doen — vallen ze vaak door de mand. Onderzoekers werken daarom aan een oplossing die mensen als vanzelfsprekend gebruiken: tastzin.
Waarom zien niet genoeg is
De meeste robots leren tegenwoordig via zogeheten vision-language-action-modellen (VLA's). Die worden eerst getraind op enorme hoeveelheden foto's, video's en tekst van het internet, en daarna verder geschoold met opnames van mensen die op afstand een robot besturen, een vorm van teleoperatie. Zo leren robots taken als was vouwen of een keukenapparaat bedienen op basis van camerabeelden en gesproken instructies. Maar bij precisiewerk schiet camerabeeld tekort. "Bijna alle behendige manipulatie kunnen mensen met hun ogen dicht", zegt Trevor Darrell, hoogleraar computerwetenschappen aan de University of California, Berkeley. Kracht voelen, merken dat iets wegglipt en precies grijpen lukt niet goed met alleen een camera. Het probleem is dat data van tastsensoren schaars is vergeleken met de bijna onuitputtelijke voorraad beeld- en tekstdata op internet.
Twee 'breinen' voor snelheid en gevoel
Darrells team bouwde de dataset T-Rex: honderd uur zorgvuldig verzamelde tastdata, met meer dan tweehonderd huishoudelijke voorwerpen en handelingen als vegen, grijpen, draaien en schenken. Tastfeedback moet razendsnel verwerkt worden, sneller dan een taalmodel doorgaans reageert. De oplossing was twee gespecialiseerde submodellen, "experts" genoemd. Eén expert bepaalt de grove bewegingsplanning, de andere — die vier keer zo snel werkt — past die planning in real time aan op basis van wat de robot voelt. Na verdere training op ongeveer honderd demonstraties van complexere taken, zoals een lampje indraaien of een ei tussen bakjes overzetten, haalde het systeem een slagingspercentage van 65 procent over twaalf taken. Dat is bijna het dubbele van het beste bestaande VLA-model zonder tastzin.
Op zoek naar universele tastdata
Een probleem blijft: Darrells data komt van één type robothand, terwijl robothanden en tastsensoren onderling sterk verschillen — van vijfvingerige grijpers tot simpele klemmen, en van sensoren die weerstand meten tot sensoren die een vervormend gelkussen filmen. Daardoor is tastonderzoek meestal gebonden aan specifieke hardware, zegt Chengbo Yuan, masterstudent aan Tsinghua University in Peking. Zijn team verzamelde ruim drieduizend uur openbare tastdata van eenentwintig verschillende sensortypes en bouwde een model dat, ongeacht de sensor, elk signaal vertaalt naar een gedeeld formaat op een sjabloon van een mensenhand. Dat leverde volgens Yuan een soort "gemeenschappelijk tastgevoel" op, ook bij hardware die het model nooit eerder zag. Toch is er meer nodig, denkt Yuan. Zijn groep leidt inmiddels een samenwerking van tachtig instituten om een grotere, gestandaardiseerde verzameling tastdata op te bouwen. Ondertussen claimen Fudan University in Shanghai en spin-off NeoteAI al een dataset die tien keer groter is: meer dan dertigduizend uur aan gesynchroniseerde beeld- en tastopnames, verzameld met een eigen sensor op robotarmen en een handbediende grijper.
Achtergrond & begrippen
Wat betekent dit voor de toekomst? Als robots straks net als mensen op hun gevoel kunnen vertrouwen, komt fijn werk zoals stekkers insteken, medicijnen doseren of onderdelen monteren dichterbij. Dat opent de deur naar robots die breder inzetbaar zijn in fabrieken, zorg en huishoudens, zonder dat voor elke taak apart geprogrammeerd hoeft te worden.
- Vision-language-action-model (VLA)
- Een AI-model dat beeld, taal en robotbesturing combineert om taken uit te voeren op basis van camerabeelden en gesproken instructies.
- Teleoperatie
- Het op afstand besturen van een robot door een mens, vaak gebruikt om trainingsdata voor AI-modellen te verzamelen.
- Tactiele sensor
- Een sensor die aanraking, druk of slip meet, vergelijkbaar met de tastzin van een mens.
- Imitatieleren
- Een trainingsmethode waarbij een AI-systeem leert door menselijke demonstraties na te bootsen.
- Behendige manipulatie
- Het vermogen om met precisie kleine of lastige objecten vast te pakken en te bewerken, zoals een sleutel omdraaien.
- Hardware-agnostisch model
- Een AI-model dat werkt met data van uiteenlopende sensoren of apparaten, zonder dat het is toegespitst op één specifiek type hardware.
Bronnen
Dit artikel is met behulp van AI geschreven op basis van bovenstaande bronnen en is geen letterlijke vertaling. Zo werkt onze redactie.