AI & computing › Neuromorfe & fotonische chips
Nvidia's nieuwe AI-chips halen tot 40% meer rekenkracht uit dezelfde stroom
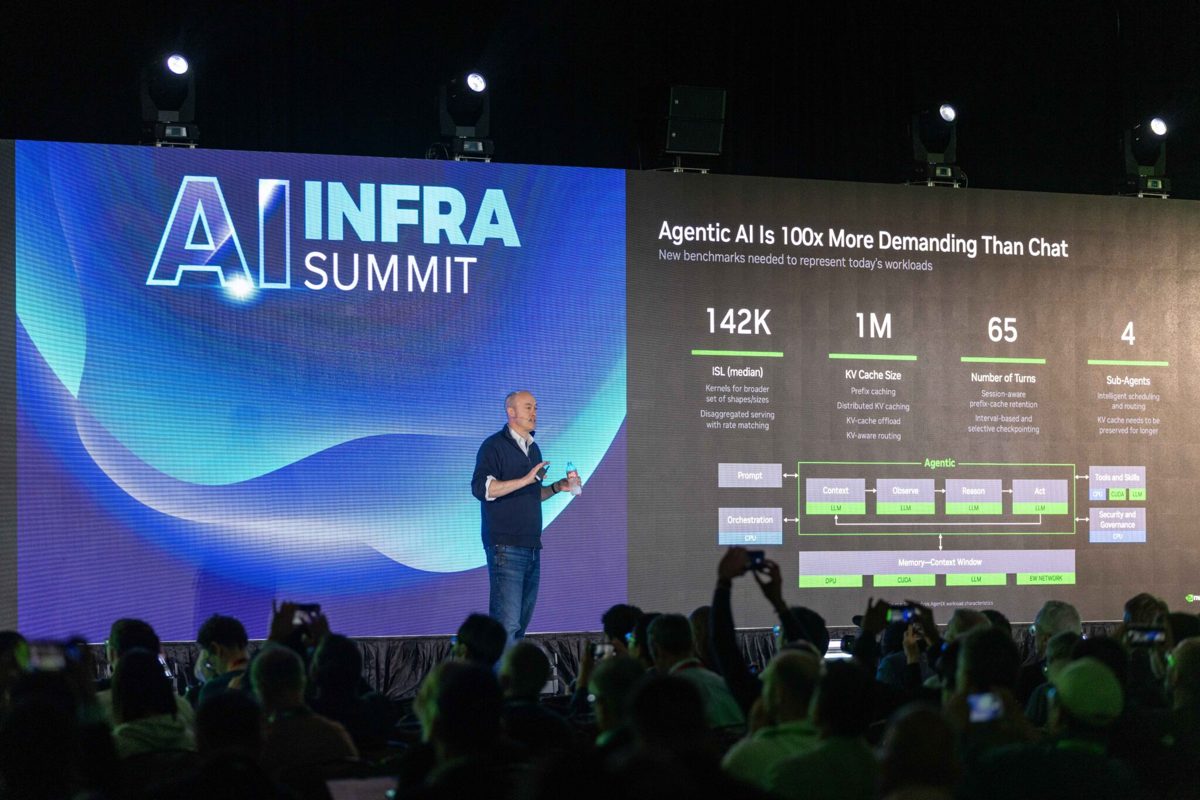
Chipmaker Nvidia toonde deze week op de AI Infra Summit in Santa Clara nieuwe testresultaten en samenwerkingen die laten zien hoeveel efficiënter datacenters voor kunstmatige intelligentie worden. Met de nieuwe Vera Rubin-chips en slimme stroomsoftware wil het bedrijf tot 40 procent meer rekenkracht uit dezelfde hoeveelheid elektriciteit halen, terwijl datacenters ook flexibeler worden voor het elektriciteitsnet.
Nvidia liet deze week op de AI Infra Summit in Santa Clara zien hoe ver de nieuwste generatie AI-chips is met energiezuinig rekenen. Het bedrijf noemt tokens per megawatt inmiddels de belangrijkste maatstaf voor AI-fabrieken: grote datacenters die non-stop taalmodellen laten draaien. Vicepresident Ian Buck sprak voor meer dan 8.000 bezoekers, ruim twee keer zoveel als vorig jaar, over hoe chips, netwerken en software voor AI-inferentie, zoals Nvidia's eigen Dynamo-software, samen minder stroom per antwoord moeten verbruiken.
Meer rekenkracht per megawatt
Centraal staat de nieuwe Vera Rubin-serie, de opvolger van de huidige Blackwell-chips. Daarbij hoort software genaamd DSX MaxLPS, die stroom binnen een GPU-cluster voortdurend herverdeelt tussen rekken met chips. Omdat trainings- en inferentietaken een ander stroompatroon hebben, vindt de software plekken waar vermogen anders onbenut blijft. Volgens Nvidia levert dat tot 40 procent meer GPU-capaciteit op binnen hetzelfde stroombudget, en tot 1,4 keer zoveel tokens per watt. Cloudaanbieder Lambda testte de software al op Blackwell-servers: 19 rekken draaiden binnen het stroombudget van 16, met 24 procent meer doorvoer en 23 procent betere prestaties per watt.
Recordcijfers in onafhankelijke test
De cijfers worden ondersteund door resultaten uit MLPerf Inference v6.1, de onafhankelijke benchmark van MLCommons waarbij elk resultaat vooraf wordt gecontroleerd door vakgenoten. Het nieuwe Vera Rubin NVL72-systeem haalde in zijn eerste test tot 3,7 keer meer doorvoer dan het huidige GB300 NVL72. Dat laatste systeem liet intussen zien hoe goed het opschaalt: een opstelling met 288 GPU's, verdeeld over vier rekken, bereikte 99 procent schaal-efficiëntie ten opzichte van één los rek. Alleen al door software te verbeteren, zonder nieuwe chips, steeg de snelheid met tot 1,6 keer sinds de vorige testronde.
AI-datacenters als speler op het stroomnet
Nvidia werkt ook aan een andere kant van het probleem: de druk op het elektriciteitsnet. Samen met partner Emerald AI en energiebedrijf Silicon Valley Power testte het bedrijf een systeem dat een AI-fabriek automatisch minder stroom laat verbruiken zodra het net daarom vraagt. Minder belangrijke rekentaken pauzeren tijdelijk, terwijl de belangrijkste taken gewoon doorgaan. Zo kan een datacenter fungeren als flexibele stroomafnemer in plaats van een vaste, onveranderlijke belasting. Voor de zwaarste AI-taken, zoals digitale 'agents' die stap voor stap redeneren, introduceert Nvidia bovendien de Groq 3 LPX-versneller. Die belooft tot 35 keer meer tokens per megawatt dan het huidige GB200 NVL72-systeem bij grote taalmodellen met een lange context.
Achtergrond & begrippen
Wat betekent dit voor de toekomst? Nu elektriciteit steeds vaker de beperkende factor is voor AI-groei, verschuift de focus van 'hoe snel' naar 'hoe zuinig' een chip rekent. Software die stroom slim herverdeelt en datacenters die meebewegen met het elektriciteitsnet kunnen ervoor zorgen dat AI-diensten blijven groeien zonder dat daar evenredig veel nieuwe energiecentrales voor nodig zijn. Dat maakt de energie-efficiëntie van chips minstens zo belangrijk als hun rekenkracht.
- Tokens per megawatt / tokens per watt
- Een maatstaf die aangeeft hoeveel AI-output (tokens, de bouwstenen van tekst) een systeem produceert per eenheid stroom die het verbruikt.
- AI-fabriek
- Een grootschalig datacenter dat specifiek is ingericht om continu AI-modellen te trainen en te laten draaien.
- GPU-cluster
- Een groep grafische chips die samen als één rekensysteem AI-taken uitvoeren.
- AI-inferentie
- De fase waarin een getraind AI-model daadwerkelijk wordt gebruikt om antwoorden of resultaten te genereren.
- MLPerf Inference
- Een onafhankelijke, veelgebruikte benchmark van het MLCommons-consortium waarmee de snelheid van AI-hardware wordt vergeleken.
- Schaal-efficiëntie
- Het percentage van de theoretisch maximale snelheidswinst dat een systeem echt haalt als je er meer chips aan toevoegt.
- DSX MaxLPS
- Software van Nvidia die stroom binnen een datacenter dynamisch verdeelt over racks, zodat minder vermogen onbenut blijft.
- Flexibele stroomafnemer
- Een grootverbruiker die zijn stroomvraag tijdelijk kan verlagen wanneer het elektriciteitsnet daarom vraagt, in ruil voor stabiliteit van het net.
- Vera Rubin NVL72
- De volgende generatie AI-serversysteem van Nvidia, opvolger van de huidige Blackwell-chips.
- Lange context
- De hoeveelheid tekst of informatie die een AI-model tegelijk kan 'onthouden' en gebruiken bij het genereren van een antwoord.
Bronnen
Dit artikel is met behulp van AI geschreven op basis van bovenstaande bronnen en is geen letterlijke vertaling. Zo werkt onze redactie.