AI & computing › Generatieve AI & synthetische media
Onderzoek Berkeley: LLM's bedreigen vrijheid van denken in recht, media en onderwijs
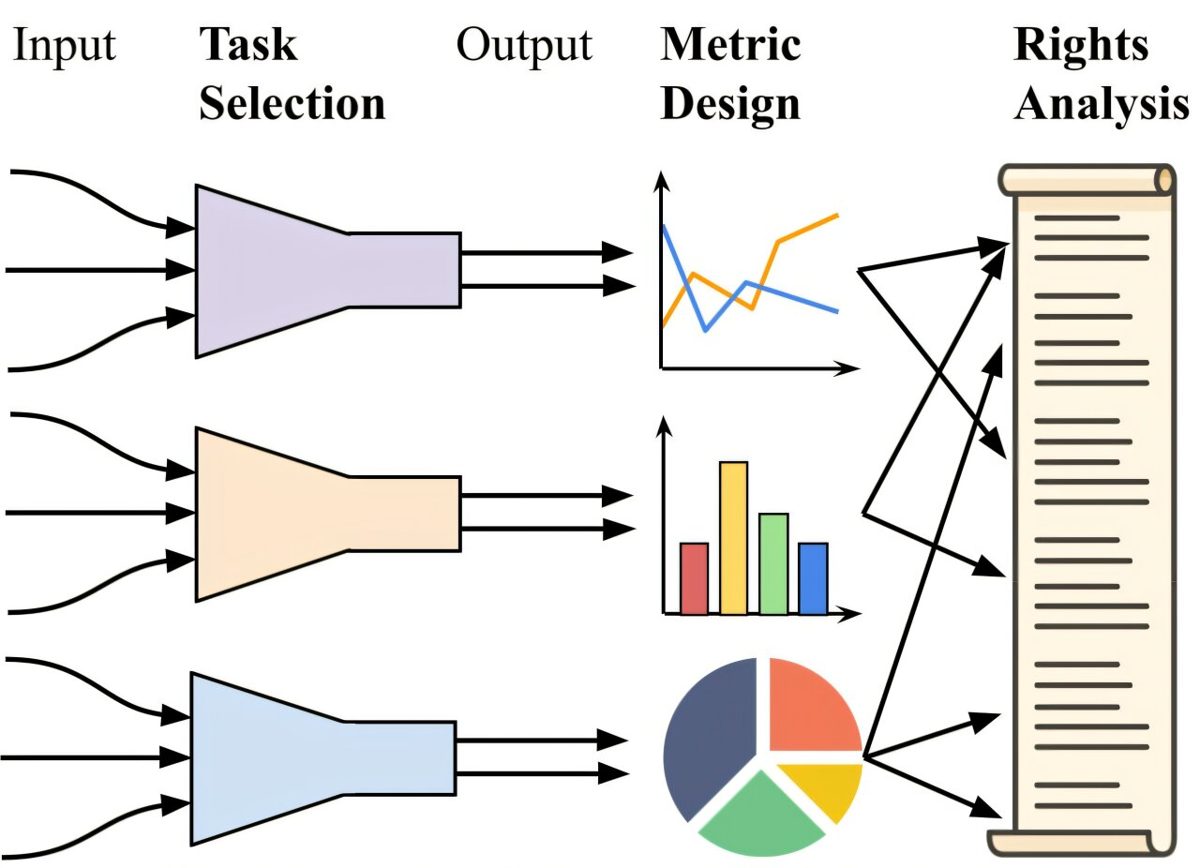
Het Human Rights Center van UC Berkeley concludeert dat het gebruik van taalmodellen als ChatGPT in de rechtspraak, journalistiek en het onderwijs zowel kansen als risico's voor mensenrechten met zich meebrengt. Vooral overmatig vertrouwen op AI kan kritisch denken ondermijnen en bestaande ongelijkheid vergroten, blijkt uit interviews met 56 experts in 24 landen.
Onderzoekers van het Human Rights Center aan de UC Berkeley School of Law brachten in kaart hoe het gebruik van large language modellen (LLM's) mensenrechten raakt in drie beroepsgroepen: recht, journalistiek en onderwijs. Voor het rapport, getiteld 'An International Analysis of the Human Rights Impacts of Large Language Models', spraken de onderzoekers Betsy Popken, Vyoma Rahman en Camille Chabot tussen 2023 en 2025 met 56 deskundigen en professionals uit 24 landen. Zij combineerden die gesprekken met een analyse van bestaande evaluaties van AI-modellen.
Een opvallende uitkomst: hoe mensen met AI-chatbots omgaan, verschilt sterk per regio. Professionals in rijke landen in het Globale Noorden zijn volgens de onderzoekers veel voorzichtiger met het gebruik van LLM's dan hun collega's in delen van het Globale Zuiden. Die laatste groep ontdekt daardoor juist nieuwe toepassingen die in het Noorden onderbelicht blijven, aldus Popken.
Kritisch denken onder druk
Het onderzoek signaleert twee risico's die in alle drie de sectoren spelen. Ten eerste kan te veel vertrouwen op AI het vermogen tot kritisch nadenken uithollen: als mensen structureel de uitkomst van een taalmodel overnemen, trainen ze hun eigen denkvermogen minder. Ten tweede leidt de manier waarop LLM's zijn getraind tot culturele en ideologische versmalling. Omdat de meeste modellen zijn gebouwd op westerse data, dreigen lokale perspectieven te verdwijnen, wat volgens de onderzoekers een risico vormt voor gelijke behandeling wereldwijd.
Verschillen per sector
In de rechtspraak kunnen LLM's mensen zonder advocaat helpen bij eenvoudige zaken, zoals geschillen bij de kantonrechter. Maar wie in complexere, risicovolle zaken blindvaart op AI-advies, loopt kans op onjuist of te weinig genuanceerd advies. Dat kan het recht op een eerlijk proces ondermijnen.
In de journalistiek ondersteunen taalmodellen redacteuren bij schrijfwerk en research, wat vooral in regio's met weinig middelen de productiviteit verhoogt. Het keerzijde is AI-hallucinatie: taalmodellen verzinnen soms feiten, wat kan bijdragen aan de verspreiding van desinformatie.
In het onderwijs maken gepersonaliseerde leersystemen het voor docenten makkelijker om leerlingen individueel te begeleiden. Tegelijk blijkt het lastig om generatieve AI goed te laten aansluiten op officiële lesdoelen, en roept het gebruik ervan vragen op over hoe leerlingen nog leren om dingen te onthouden.
Aanbevelingen aan bedrijven en toezichthouders
De onderzoekers doen concrete aanbevelingen aan bedrijven die LLM's bouwen. Zo pleiten ze voor trainingsdata die wereldwijde gemeenschappen beter vertegenwoordigen, voor AI-guardrails die zwaarder ingrijpen naarmate een risico ernstiger is, en voor gespecialiseerde taalmodellen per vakgebied in plaats van één model voor alles. Aan overheden en toezichthouders adviseren ze heldere procedures voor herstel van schade, verplichte mensenrechtentoetsen gedurende de hele levenscyclus van een AI-model, en gerichte regels voor risicovolle toepassingen, zoals rechters die AI raadplegen bij het schrijven van vonnissen. Het rapport bouwt voort op een eerder raamwerk van dezelfde onderzoeksgroep, dat in 2025 werd gepresenteerd op de AAAI/ACM-conferentie over AI, ethiek en samenleving.
Achtergrond & begrippen
Wat betekent dit voor de toekomst? Naarmate taalmodellen dieper doordringen in cruciale sectoren als recht, media en onderwijs, groeit het belang van zorgvuldig ontworpen waarborgen en regionaal aangepaste trainingsdata. Zonder ingrijpen dreigen bestaande ongelijkheden tussen rijke en arme landen zich te vertalen naar ongelijke toegang tot betrouwbare AI. Toezichthouders en ontwikkelaars staan voor de opgave om innovatie te combineren met bescherming van fundamentele rechten zoals een eerlijk proces en vrije meningsvorming.
- Large language model
- Een AI-systeem dat is getraind op enorme hoeveelheden tekst en daardoor mensachtige taal kan begrijpen en genereren, zoals de modellen achter ChatGPT.
- AI-hallucinatie
- Het verschijnsel waarbij een taalmodel met overtuiging informatie presenteert die feitelijk onjuist of verzonnen is.
- Generatieve AI
- Kunstmatige intelligentie die zelfstandig nieuwe tekst, beeld of ander materiaal kan produceren op basis van een gebruikersvraag.
- AI-guardrails
- Ingebouwde beperkingen en veiligheidsmaatregelen in een AI-systeem die moeten voorkomen dat het schadelijke of ongepaste antwoorden geeft.
Bronnen
Dit artikel is met behulp van AI geschreven op basis van bovenstaande bronnen en is geen letterlijke vertaling. Zo werkt onze redactie.